
디지털사회 제77호: 당신의 AI는 지금 어디에 있습니까?
작성자
ssk
작성일
2026-08-21 15:41
조회
201
당신의 AI는 지금 어디에 있습니까?
이기창(연세대학교 첨단융합공학부)
[내 손안의 AI가 바꾸는 데이터와 프라이버시의 미래]
아침에 눈을 뜨자마자 스마트폰에 묻는다. “오늘 우산 가져가야 해?” 몇 초 뒤 답이 돌아온다. 출근길에는 이어폰이 주변 소음을 줄여주고, 스마트폰 카메라는 사진 속 사람과 배경을 구분한다. 자동차는 차선을 인식하고, 스마트워치는 하루 동안의 심박수와 활동량을 분석한다. 우리는 이런 기능을 자연스럽게 인공지능이라고 부른다.그런데 한 가지 질문을 던져보자. 방금 내 목소리를 들은 인공지능은 ‘어디에’ 있었을까?
내 손에 들린 스마트폰 안에 있었을까. 아니면 내 목소리가 인터넷을 타고 멀리 떨어진 데이터센터로 이동한 뒤, 그곳의 컴퓨터가 답을 만들어 다시 보내준 것일까.
사용자 입장에서는 큰 차이가 없어 보인다. 화면에는 똑같이 결과가 나타난다. 하지만 데이터의 입장에서는 전혀 다른 이야기다. 내 음성이 어디까지 이동했는지, 사진이 스마트폰 밖으로 나갔는지, 건강정보가 어느 서버에서 분석되었는지에 따라 프라이버시와 보안의 조건은 달라진다.
앞으로의 인공지능을 이해하기 위해서는 “얼마나 똑똑한가”만큼이나 “어디에서 작동하는가”를 살펴볼 필요가 있다.
[우리는 지금까지 ‘멀리 있는 AI’를 사용해왔다]
지금까지 많은 인공지능 서비스는 사용자의 기기 안이 아니라 외부의 데이터센터에서 작동해 왔다. 스마트폰이나 노트북은 입력을 받아 서버로 보내고 결과를 전달받는 일종의 창구 역할을 했다.쉽게 말하면 클라우드 AI는 ‘멀리 있는 거대한 두뇌를 빌려 쓰는 방식’이다.
이 방식에는 분명한 장점이 있다. 스마트폰으로는 실행하기 어려운 크고 복잡한 인공지능 모델도 데이터센터에서는 사용할 수 있다. 서비스 제공자는 중앙에서 모델을 관리하고 업데이트할 수 있으며, 이용자는 별도의 고성능 컴퓨터 없이도 강력한 인공지능 기능을 사용할 수 있다.
문제는 AI에게 보내는 질문만 서버로 가는 것이 아니라는 점이다.
사진을 분석하려면 사진이 이동해야 하고, 음성을 이해하려면 음성 데이터가 이동해야 한다. 건강 상태를 분석하는 서비스라면 생체신호나 생활 기록이 전송될 수도 있다. 친구와 찍은 사진, 집 안의 목소리, 위치 기록, 심박수와 수면정보처럼 상당히 개인적인 데이터가 서비스 이용 과정에서 기기 밖으로 이동할 수 있는 것이다.
물론 데이터가 외부 서버로 전송된다고 해서 곧바로 개인정보가 유출된다는 뜻은 아니다. 암호화와 접근 통제 등 다양한 보안 기술이 사용된다. 그러나 데이터가 이동하는 순간 우리가 신뢰해야 하는 대상은 늘어난다. 사용자의 기기뿐 아니라 통신망과 서버, 데이터 저장 과정도 안전해야 한다. 어떤 정보가 얼마나 오래 보관되는지, 다른 목적으로 활용되는지 역시 중요한 문제가 된다.
이러한 이유로 최근 인공지능은 조금씩 다른 방향으로 움직이고 있다. 멀리 있는 데이터센터에서만 작동하던 AI가 사용자의 기기 안으로 들어오기 시작한 것이다.
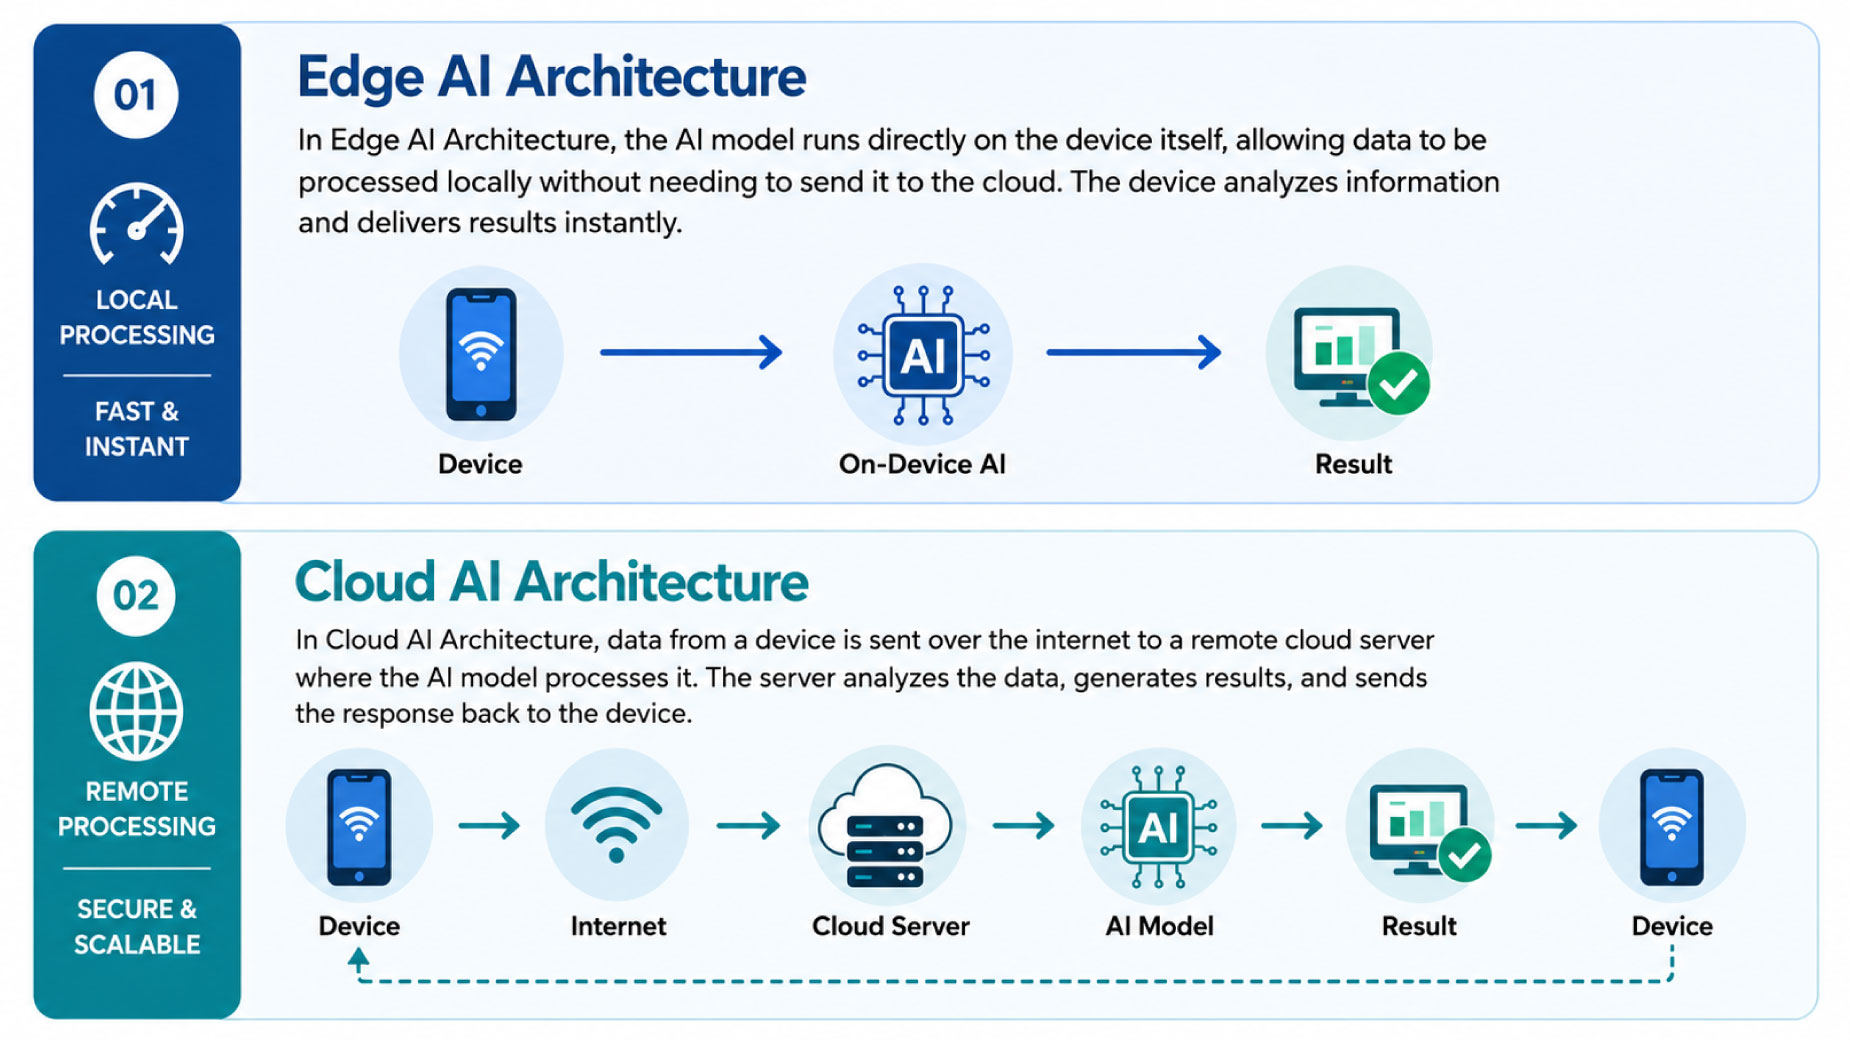
[그림 1] 클라우드 AI 구조 vs. Edge AI 구조 [1]
[AI가 우리 손안으로 들어오고 있다]
최근 스마트폰이나 노트북 광고에서 ‘온디바이스 AI’라는 표현을 자주 볼 수 있다.이름은 다소 어렵지만 원리는 간단하다. 인공지능에 필요한 계산을 외부 서버에 보내지 않고 스마트폰, 자동차, 웨어러블 기기 같은 사용자 기기 안에서 직접 수행하는 방식이다 [2].
클라우드 AI가 멀리 있는 거대한 두뇌라면, 온디바이스 AI는 작지만 나와 가까이 있는 두뇌라고 볼 수 있다.
예를 들어 스마트폰이 사진 속 얼굴과 배경을 구분한다고 해보자. 이 작업을 위해 사진 전체를 서버로 보낼 수도 있지만, 기기 안의 인공지능이 직접 분석할 수도 있다. 이어폰의 소음 제거 역시 주변에서 들어오는 소리를 인터넷으로 보내지 않고 기기 내부에서 실시간으로 처리할 수 있다.
자동차와 같은 경우 이런 차이가 더 중요해진다. 갑자기 도로로 사람이 뛰어들었는데 차량이 영상을 데이터센터에 보내고 답을 기다릴 수는 없다. 카메라 영상은 차량 내부에서 곧바로 분석되어야 한다.
따라서 온디바이스 AI는 프라이버시뿐 아니라 반응 속도 측면에서도 유리하다. 데이터가 네트워크를 오갈 필요가 없기 때문에 지연을 줄일 수 있고, 인터넷 연결이 불안정한 환경에서도 기능을 사용할 수 있다.
다만 모든 인공지능을 기기 안에서 실행할 수 있는 것은 아니다. 최근의 거대한 AI 모델은 많은 연산과 메모리, 전력을 필요로 한다. 데이터센터에는 고성능 가속기와 냉각 장치가 있지만 스마트폰에는 제한된 배터리와 작은 칩만 존재한다.
그래서 온디바이스 AI에서는 “AI를 얼마나 더 크게 만들 것인가”와 다른 질문이 중요해진다. “작은 기기에서도 충분히 잘 작동하게 만들 수 있는가”라는 질문이다. 모델의 크기를 줄이고, 불필요한 계산을 없애고, 기기의 성능과 배터리 상황에 맞게 인공지능을 실행하는 기술이 필요한 이유다 [3,4].
결국 미래의 인공지능은 클라우드와 기기 중 하나만을 선택하기보다는 두 방식을 적절히 섞는 방향으로 발전할 가능성이 높다. 민감하거나 빠른 처리가 필요한 작업은 기기에서 수행하고, 더 큰 계산이 필요한 경우에는 서버를 활용하는 식이다.
그러나 여기서 한 가지 오해를 피해야 한다.
AI가 기기 안에서 작동한다고 해서 자동으로 안전해지는 것은 아니다.
[“기기 안에서 처리됩니다”라는 말은 어디까지 맞을까]
“이 데이터는 기기 안에서 처리됩니다.”사용자 입장에서는 안심되는 문장이다. 하지만 조금만 자세히 보면 여러 질문이 생긴다.
무엇이 기기 안에 남는 것일까?
원본 사진은 외부로 보내지 않더라도 사진에서 추출된 얼굴 특징이나 위치 정보가 서버로 전달될 수 있다. 음성 녹음 자체는 전송하지 않지만 사용자의 말투나 이용 패턴을 분석한 정보가 전송될 수도 있다.
즉 원본 데이터가 이동하지 않는 것과 그 데이터로부터 얻어진 모든 정보가 기기에 남는 것은 다른 이야기다.
AI 모델 자체가 새로운 공격 대상이 될 수도 있다. 어떤 모델이 개인의 데이터로 학습되었다면, 공격자는 모델이 전달하는 정보나 출력 결과를 분석해 학습 데이터의 특징을 추론하려 할 수 있다 [5]. 원본 데이터 파일을 직접 훔치지 않고도 모델을 통해 간접적으로 정보를 얻는 것이다.
기기 자체가 공격받는 문제도 있다. 스마트폰 내부에 저장된 AI 모델을 분석하거나, 입력을 교묘하게 조작해 잘못된 판단을 유도할 수도 있다.
따라서 인공지능의 프라이버시를 평가할 때는 “데이터를 서버로 보냈는가”라는 질문 하나만으로는 부족하다. 어떤 정보가 기기에 남는지, 어떤 정보가 외부로 전달되는지, 모델이 어떤 정보를 학습하고 노출할 가능성이 있는지까지 함께 살펴야 한다.
그리고 최근에는 여기서 한 단계 더 나아간 방식도 등장했다.
여러 사람이나 기관이 데이터를 서로 보여주지 않고도 하나의 AI를 함께 학습시키는 방법이다.
[데이터를 모으지 않고 함께 배우는 AI]
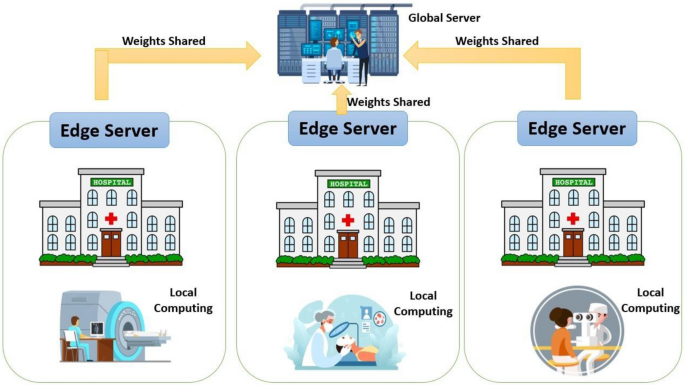
[그림 2] 병원 간 연합학습 모식도 [6]
여러 병원이 질병 예측 AI를 함께 개발한다고 가정해보자.가장 단순한 방법은 각 병원의 환자 데이터를 하나의 장소에 모은 뒤 인공지능을 학습하는 것이다. 그러나 진료기록과 생체신호처럼 민감한 의료데이터를 한곳에 집중시키는 것은 상당한 부담과 위험을 만든다.
그렇다면 각 병원이 환자 데이터를 보유한 채로 함께 AI를 만들 수는 없을까?
이 질문에서 출발한 대표적인 기술이 ‘연합학습’이다 [7].
연합학습은 여러 학생이 시험공부를 하는 모습에 비유할 수 있다. 학생들이 자신의 공책을 한 사람에게 모두 넘기는 대신, 각자 자신의 공책을 보며 공부한다. 그리고 공책 자체가 아니라 “공부해보니 이 부분을 이렇게 고치는 것이 좋았다”는 학습 결과만 공유한다. 여러 학생의 결과를 합쳐 더 나은 공부 방법을 만들고 다시 나누어 갖는 것이다.
병원도 마찬가지다. 환자 데이터는 병원 내부에 남겨둔 채 각 병원이 자체 데이터를 이용해 AI를 학습하고, 학습 과정에서 변화한 정보만 서버로 보낸다. 서버는 여러 병원의 결과를 합쳐 더 나은 모델을 만들고 다시 참여 기관에 전달한다.
스마트폰이나 자동차도 이런 방식으로 협력할 수 있다. 서울에서 운전하는 차량은 복잡한 교차로를 많이 경험하고, 강원도의 차량은 눈길을 많이 경험할 수 있다. 촬영한 영상을 모두 한곳에 모으지 않고도 서로 다른 환경에서 얻은 경험을 AI 학습에 반영할 수 있다.
듣기에는 이상적인 방법이지만 새로운 문제가 생긴다.
만약 학습에 참여한 사람 중 누군가가 악의적인 정보를 보내면 어떻게 될까?
수천 대의 스마트폰 가운데 일부가 해킹되어 있다면 공격자는 조작된 학습 결과를 보내 전체 모델의 성능을 떨어뜨릴 수 있다 [8]. 또한 각 기기가 전달하는 학습 정보를 분석해 원래 사용자의 데이터를 추론하려는 공격도 가능하다.
즉 데이터를 한곳에 모으지 않는다고 해서 프라이버시와 보안 문제가 사라지는 것은 아니다. 데이터 대신 모델과 학습 과정이 새로운 보호 대상이 된다 [9].
필자가 모바일·분산형 AI 시스템의 보안과 프라이버시를 연구하면서 흥미롭게 느끼는 점도 여기에 있다. 데이터를 분산시키는 것은 중요한 출발점이지만 그 자체가 안전을 보장하지는 않는다. AI가 여러 기기와 기관으로 분산될수록 보호해야 하는 대상과 신뢰해야 하는 참여자 역시 늘어나기 때문이다.
[AI의 위치가 달라지면 책임의 위치도 달라진다]
AI가 하나의 데이터센터에 있을 때는 시스템의 중심도 비교적 명확하다. 그러나 인공지능이 스마트폰과 자동차, 병원과 공장으로 분산되면 책임 구조 역시 복잡해진다.자동차의 인공지능이 보행자를 제대로 인식하지 못했다고 해보자. 카메라 센서의 문제일 수도 있고, AI 모델의 오류일 수도 있다. 차량의 계산 장치가 오래되어 최신 모델을 실행하지 못했을 수도 있고, 적절한 업데이트가 제공되지 않았을 수도 있다.
여러 병원이 연합학습으로 만든 AI가 특정 환자 집단에서 낮은 성능을 보인다면 책임을 한 기관에만 돌리기도 쉽지 않다. 각 병원의 데이터 구성, 학습 방식, 결과를 합치는 서버 모두가 영향을 미칠 수 있기 때문이다.
AI가 분산될수록 데이터도 분산되지만 책임까지 모호해져서는 안 된다.
그래서 앞으로 인공지능을 둘러싼 사회적 논의에서는 “개인정보를 수집했는가”만을 묻는 것으로는 충분하지 않을 가능성이 크다. 데이터가 어디에서 생성되고 어디에서 계산되는지, 어떤 형태의 정보가 외부로 이동하는지, 사용자는 이를 이해하고 통제할 수 있는지를 함께 살펴야 한다.
사용자가 인공지능의 기술적 구조를 모두 이해할 필요는 없다. 자동차를 운전하기 위해 엔진의 작동 원리를 모두 알 필요가 없는 것과 같다.
하지만 적어도 자신의 데이터가 기기 밖으로 나가는지, 나간다면 무엇이 전달되는지, 원하지 않을 경우 이를 거부할 수 있는지는 알 수 있어야 한다.
앞으로 “기기 안에서 처리됩니다”라는 설명도 더 구체적이어야 한다. 원본 데이터만 기기에 남는 것인지, 분석 결과도 외부로 전송되지 않는 것인지, 서비스 개선을 위한 학습에는 사용되는지 등을 사용자가 쉽게 이해할 수 있도록 설명할 필요가 있다.
[더 가까운 AI를 더 믿을 수 있는 AI로]
미래의 인공지능은 하나의 거대한 데이터센터에만 존재하지 않을 것이다. 스마트폰과 자동차, 웨어러블 기기, 병원과 공장처럼 우리 주변의 수많은 장소로 흩어질 가능성이 크다.그 변화는 분명 많은 가능성을 제공한다. 민감한 데이터를 외부로 보내지 않고도 AI를 사용할 수 있고, 네트워크가 없어도 빠르게 작동할 수 있다. 서로 다른 기관과 기기가 데이터를 직접 공유하지 않은 채 함께 학습하는 것도 가능해진다.
그러나 AI가 사용자 가까이에 있다는 사실만으로 신뢰할 수 있는 AI가 되는 것은 아니다.
앞으로는 AI가 얼마나 정확한지만큼이나 몇 가지 질문이 중요해질 것이다.
내 데이터는 지금 어디에 있는가?
어떤 정보가 밖으로 이동하는가?
누가 그것을 볼 수 있는가?
그리고 문제가 발생했을 때 누가 책임지는가?
처음의 질문으로 다시 돌아가 보자.
오늘 아침 스마트폰에 “우산을 가져가야 할까?”라고 물었을 때, 그 질문에 답한 인공지능은 어디에 있었을까.
지금은 그 답을 몰라도 큰 불편이 없을지 모른다. 그러나 AI가 우리의 사진과 목소리, 위치와 건강정보, 자동차와 집까지 이해하기 시작한다면 이야기는 달라진다.
앞으로 우리는 AI에게 무엇을 물어볼 것인가뿐 아니라, 그 AI가 어디에서 답을 만들고 있는지도 생각해야 한다.
AI가 우리의 손안으로 들어오는 시대에는 지능의 크기만큼이나, 그 지능이 머무는 장소가 중요해지고 있기 때문이다.
[References]
[1] ImageVision, “Edge AI vs Cloud AI Choosing the Right Deployment Model for Enterprise Computer Vision”, 2026.
[2] Apple, “Core ML: Machine Learning Resources,” Apple Developer.
[3] M. Sandler, A. Howard, M. Zhu, A. Zhmoginov, and L.-C. Chen, “MobileNetV2: Inverted Residuals and Linear Bottlenecks,” Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), pp. 4510–4520, 2018.
[4] S. Han, H. Mao, and W. J. Dally, “Deep Compression: Compressing Deep Neural Networks with Pruning, Trained Quantization and Huffman Coding,” International Conference on Learning Representations (ICLR), 2016.
[5] L. Zhu, Z. Liu, and S. Han, “Deep Leakage from Gradients,” Advances in Neural Information Processing Systems (NeurIPS), vol. 32, 2019.
[6] Mishra, A., Saha, S., Mishra, S. et al. A federated learning approach for smart healthcare systems. CSIT 11, 39–44 (2023). https://doi.org/10.1007/s40012-023-00382-1
[7] H. B. McMahan, E. Moore, D. Ramage, S. Hampson, and B. A. y Arcas, “Communication-Efficient Learning of Deep Networks from Decentralized Data,” Proceedings of the 20th International Conference on Artificial Intelligence and Statistics (AISTATS), pp. 1273–1282, 2017.
[8] E. Bagdasaryan, A. Veit, Y. Hua, D. Estrin, and V. Shmatikov, “How To Backdoor Federated Learning,” Proceedings of the 23rd International Conference on Artificial Intelligence and Statistics (AISTATS), pp. 2938–2948, 2020.
[9] K. Bonawitz, V. Ivanov, B. Kreuter, A. Marcedone, H. B. McMahan, S. Patel, D. Ramage, A. Segal, and K. Seth, “Practical Secure Aggregation for Privacy-Preserving Machine Learning,” Proceedings of the ACM SIGSAC Conference on Computer and Communications Security (CCS), pp. 1175–1191, 2017.
디지털사회(Digital Society)는 연세대학교 디지털사회과학센터(Center for Digital Social Science)에서 발행하는 이슈브리프입니다. 디지털사회의 내용은 저자 개인의 견해이며, 디지털사회과학센터의 공식입장이 아님을 밝힙니다.
전체 0
댓글을 남기려면 로그인하세요.